论文阅读
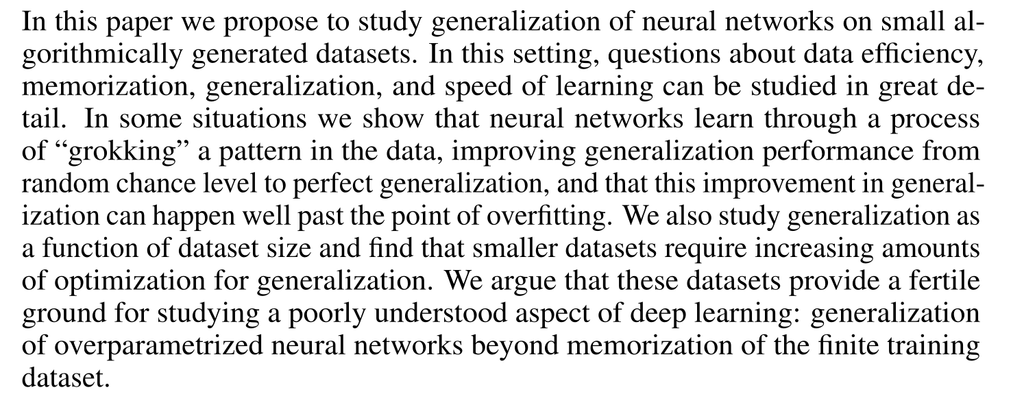
论文主要关注神经网络在过拟合点后继续训练突然泛化能力提升的现象,并探讨了泛化能力和数据集大小的关系
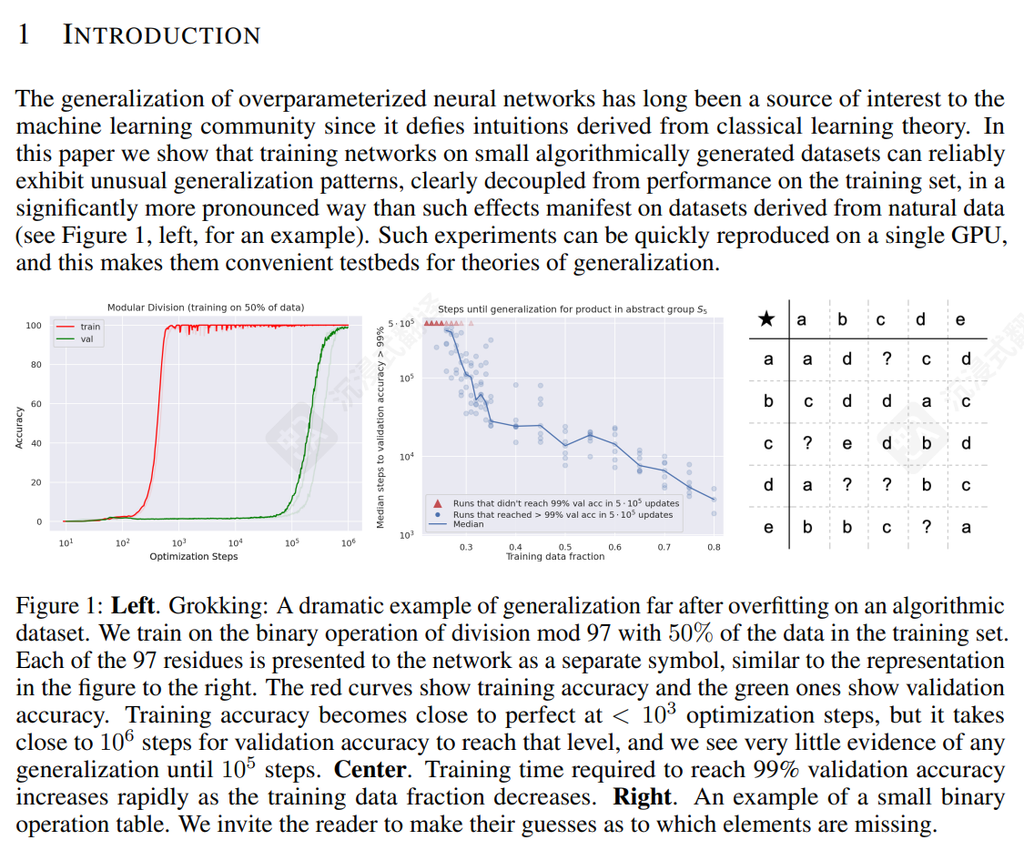
左侧红线为训练集准确度,在次训练处已经接近完美
左侧绿线为测试集准确度,在次训练处才能接近完美
中间的状态都是过拟合。
中间的图片展示了达到高测试集准确度所需训练时间随着训练数据的比例减少而增加
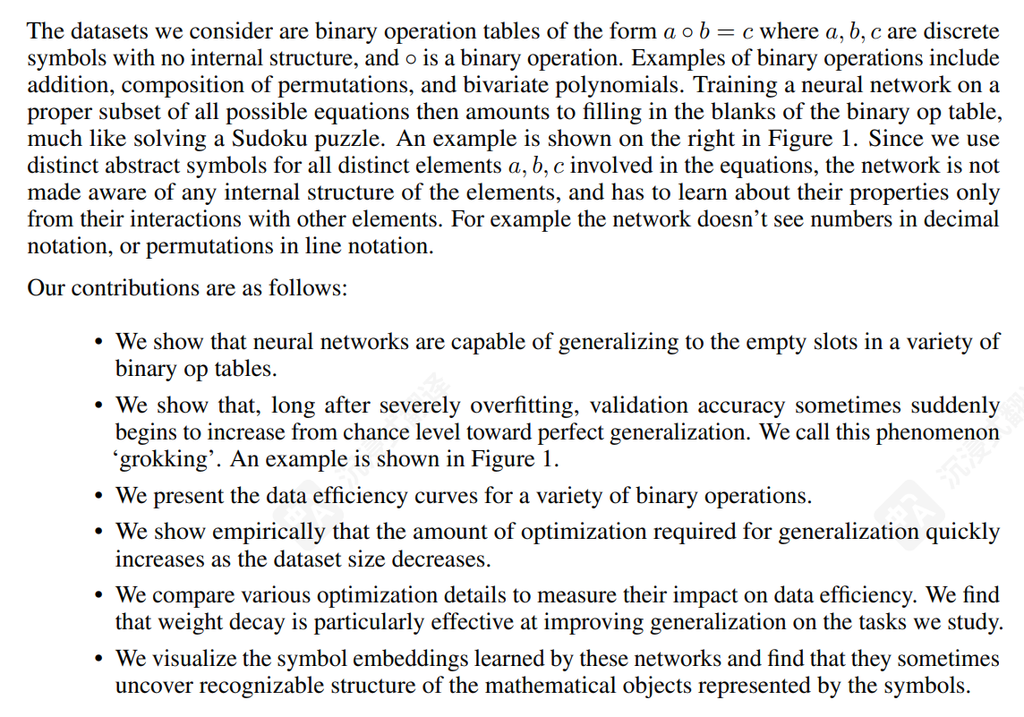
论文使用的数据集是一个形式类似 的二进制运算表,二进制运算包括加法、置换组合、双变量多项式等。
论文特意将输入输出都符号化的原因在于避免模型借助数学关系学习到和代数结构无关的内容,模型研究的只能是运算的结构。
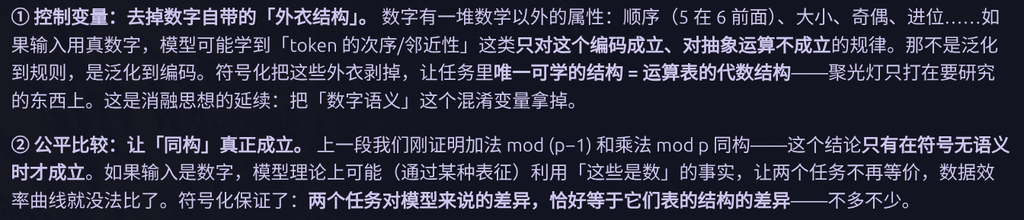
但是其中的三个数字都使用了不同的抽象符号来代替,也就是说模型网络并不知道具体的十进制数字是什么。
- 我们证明了神经网络能够泛化到各种二进制运算表中空槽的位置。
- 我们证明,在严重过拟合之后很长一段时间,验证准确率有时会突然从随机水平开始增加,直至达到完美泛化。我们将这种现象称为‘grokking’。图1展示了这样一个例子。
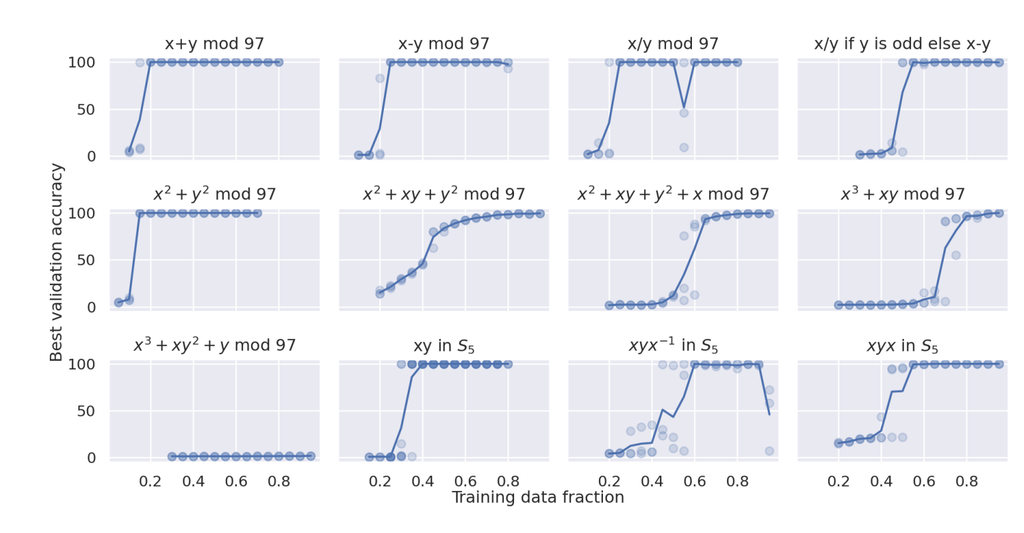
- 我们展示了各种二进制运算的数据效率曲线。
- 我们通过实证表明,泛化所需的优化量会随着数据集规模的减小而迅速增加。
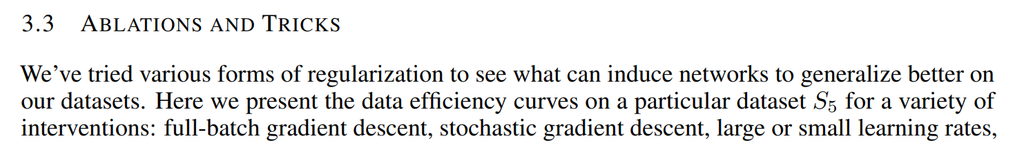
- 我们比较了各种优化细节,以衡量它们对数据效率的影响。我们发现这种权重衰减在提高我们研究的任务的泛化能力方面特别有效。
- 我们可视化这些网络学习到的符号嵌入,并发现它们有时能揭示符号所代表的数学对象的可识别结构。
使用的transformer架构。我们后面代码再看细节。
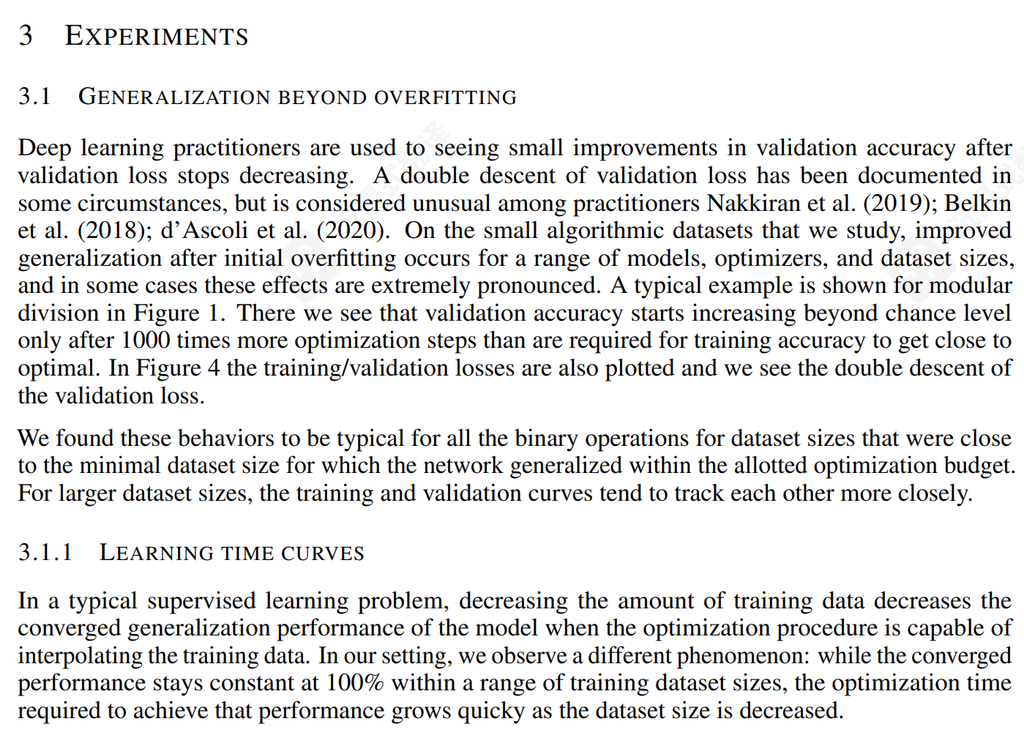
背景:深度学习从业者通常习惯于在训练损失(怀疑错误)停止下降后看到验证准确率的小幅提升。在某些情况下,验证损失出现了双重下降,但这在从业者中被认为是罕见的。
我们发现这些行为对于所有接近最小数据集大小(即网络在规定优化预算内泛化的数据集大小)的数据集大小的二进制运算都是典型的。对于更大的数据集大小,训练曲线和验证曲线倾向于更紧密地跟踪彼此。
在典型的监督学习问题中,当优化过程能够插值训练数据时,减少训练数据量会降低模型的收敛泛化性能。在我们的设置中,我们观察到一种不同的现象:当训练数据集大小在一定范围内时,收敛性能保持在100%不变,但随着数据集大小的减小,达到该性能所需的优化时间会快速增长。
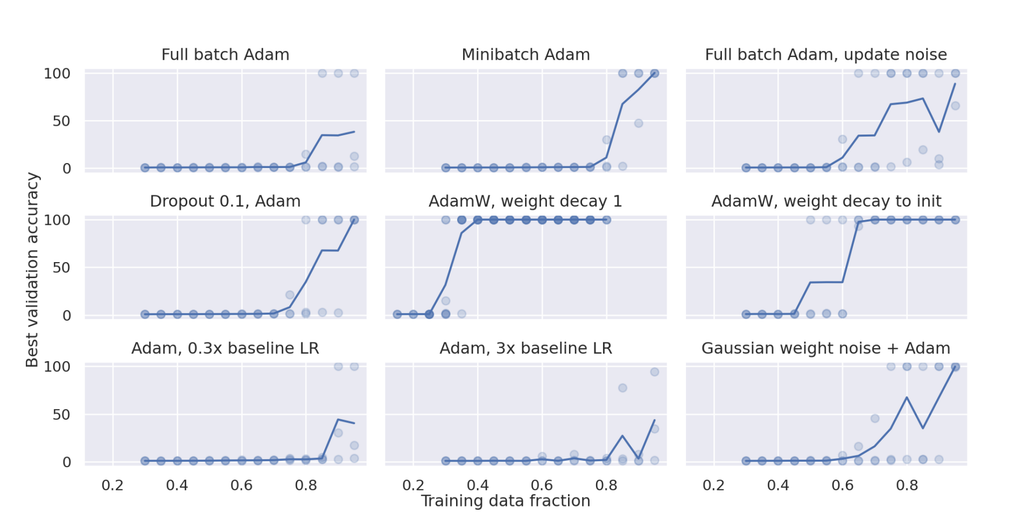
- Full batch Adam:Adam全批量
- Mini batch Adam:Adam小批量
- Full batch Adam, update noise:全批量 + 更新时的高斯噪声
- Dropout 0.1, Adam:显式正则,每步丢弃10%的残差链接输出
- AdamW, weight decay 1:每个权重每步额外向0衰减
- AdamW, weight decay to init:每个权重每步额外向初始值衰减
- Adam, 0.3x baseline LR:小步长
- Adam, 3x baseline LR:大步长
- Gaussian weight noise + Adam:前向计算的时候加高斯噪声
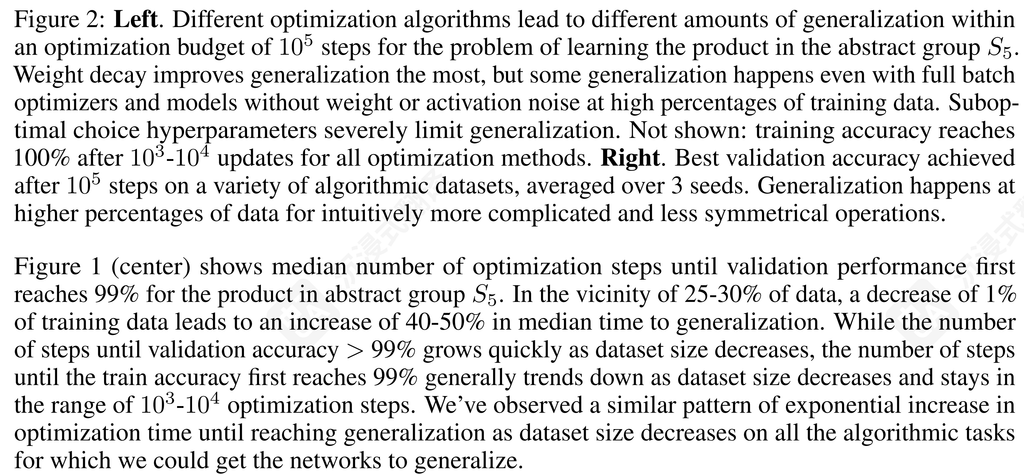
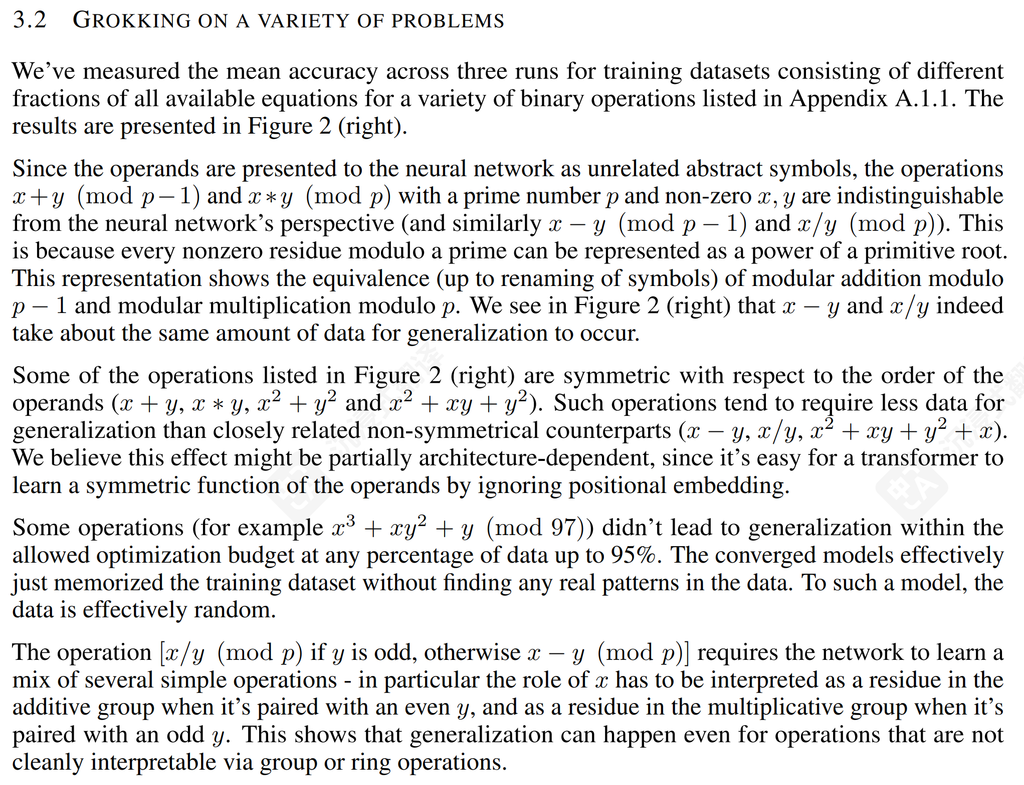
此处的数学概念补充和理解见附录
总的来说模型学习的是一个群的结构或者特征,外推去思考的话,作者人为将数字限定在p以下是因为p以上的数字在这个问题中实际上要对应到一个p以下的数字(等价类),模型还需要先学会在embedding中合并。但由于数据量和数据分布,这一合并关系的原料非常不稳定,所以不如避免这一点
在x, y的地位对称的时候,可以得到更快的收敛速度,论文认为这和Transformer可以忽视位置编码来学习操作数的对称函数相关。论文发现并不是任何映射都可以被泛化。
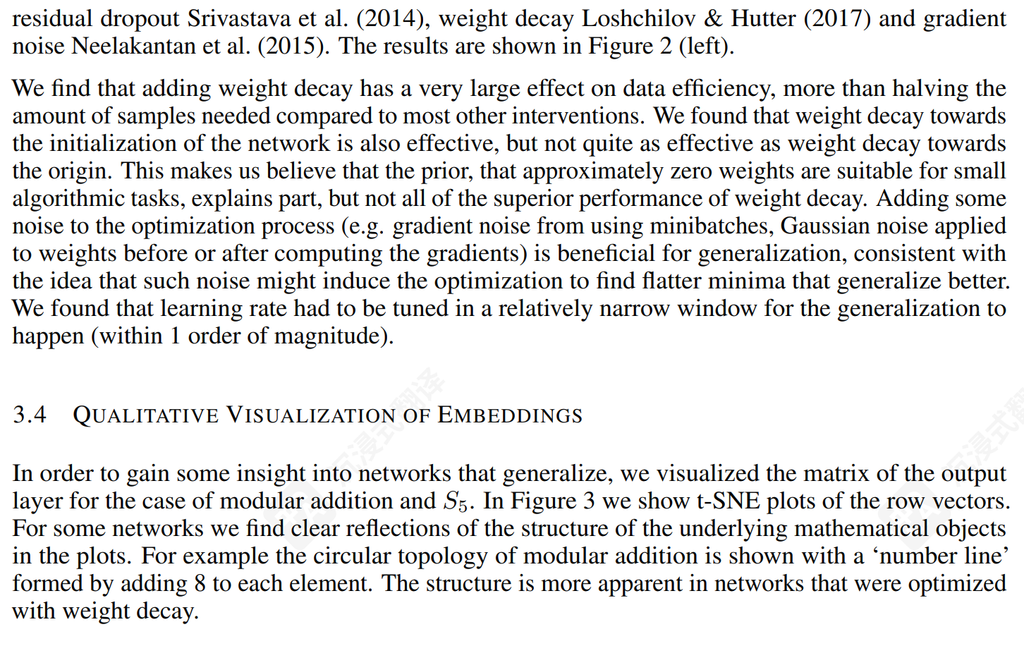
记忆解和通解在训练中同时被学习;记忆解早熟但模长巨大,通解晚成但模长极小;weight decay 持续按模长征税,使记忆解越来越贵——当通解装配完毕、总损失反超时,模型切换 → 泛化突跳。
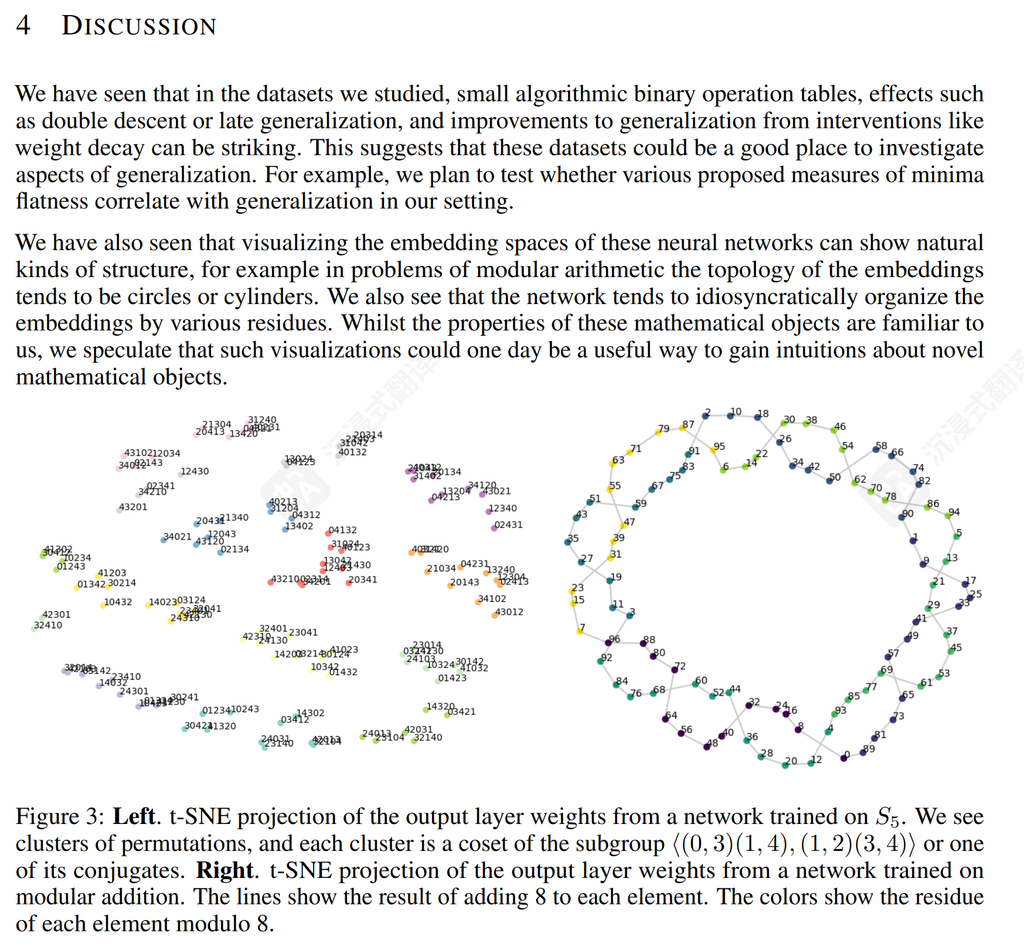
图 3:左。在 S5 上训练的网络输出层权重的 t‑SNE 投影。我们看到排列的簇,每个簇都是子群<(0, 3)(1, 4), (1, 2)(3, 4)> 或其共轭的一个陪集。右。在模加法上训练的网络输出层权重的t‑SNE 投影。线条显示了将 8 加到每个元素的结果。颜色显示了每个元素模 8 的余数
t-SNE是一种高维向量压缩方法,在高维空间中计算每对点的”相似度”,紧邻的给予高权重,然后在2D空间随机分布点的位置来使得近邻关系接近高维空间,最小化KL散度。
<(0, 3)(1, 4), (1, 2)(3, 4)>是两个循环记号,代表着两种置换。H封闭扩张后一共有10个元素:
- 一个恒等变换
- 5个二阶变换 (03)(14),(12)(34),(02)(13),(04)(23),(01)(24)
- 4个五阶(5-循环)
陪集(coset)。 把 H 整体「左乘」一个元素。陪集把 S5 的 120 个元素切成大小相等(每块 10 个)的 12 块——每块是一个陪集
左图中的同色点是同一个陪集中的10个元素,在高维空间指向相近处。
右图中展示了按照+8生成元循环生成的元素排列和mod 8后结果的颜色分布,8正好是96的因数,因此整个图像的轨道闭包。
代码复现
#!/usr/bin/env python3
"""
grokking 复现(Nanda 2023 官方配方,纯 PyTorch 重写,零外部依赖)

任务:模加法 a + b (mod P),P = 113
  - 输入:三个 token [a, b, "="],其中 "=" 是专门的读出位置(token 编号 = P)
  - 输出:P 类分类,(a+b) mod P 是哪个数,从 "=" 位置的残差流读出
模型:1 层 transformer(Nanda et al. 2023《Progress Measures for Grokking》
      demo 的忠实复刻):
  embed(+位置) → 4 头 attention(残差) → relu MLP 512(残差) → 输出层
  注意:整个模型【没有 LayerNorm】——官方配置 normalization_type=None。
  这正是 grokking 快慢的关键之一(对比 experiments/v1_slow_2tok_layernorm.py)。

复现的现象:
  1. 训练 loss 先降到很低(记住训练对)
  2. 测试集 loss/acc 长时间纹丝不动(~随机水平)
  3. 突然某个 epoch 开始,测试集在一段「静默期」后瞬间逼近完美
  这就是 grokking:泛化远晚于过拟合,像顿悟。

超参(与官方 demo 一致):
  lr=1e-3, weight_decay=1.0, betas=(0.9, 0.98), 全批量训练,
  frac_train=0.3(只给 30% 的 (a,b) 对当训练集——数据越少 grokking 越明显)
"""

import argparse
import csv
import os
import random
import sys
import time

import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F

# ----------------------------------------------------------------------------
# ① 命令行参数
# ----------------------------------------------------------------------------
def parse_args():
    p = argparse.ArgumentParser(description="grokking 复现(Nanda 2023 配方)")
    p.add_argument("--p", type=int, default=113, help="模数 P")
    p.add_argument("--frac_train", type=float, default=0.3, help="训练集占比(数据越少 grokking 越明显)")
    p.add_argument("--d_model", type=int, default=128)
    p.add_argument("--n_heads", type=int, default=4)
    p.add_argument("--d_head", type=int, default=32)
    p.add_argument("--d_mlp", type=int, default=512)
    p.add_argument("--lr", type=float, default=1e-3)
    p.add_argument("--wd", type=float, default=1.0, help="weight decay(改 0 试试,grokking 会消失)")
    p.add_argument("--steps", type=int, default=25000, help="训练步数(全批量,一步=一遍训练集)")
    p.add_argument("--eval_every", type=int, default=100)
    p.add_argument("--seed", type=int, default=0)
    p.add_argument("--watch", action="store_true", help="录参数快照,生成 param-watch 热力图")
    p.add_argument("--outdir", type=str, default="runs", help="结果输出目录")
    return p.parse_args()

# ----------------------------------------------------------------------------
# ② 数据:全部 P×P 个 (a, b) 对,随机分训练/测试
#    每个样本 = [a, b, P] 三个 token(P 是 "=" 读出 token)
# ----------------------------------------------------------------------------
def make_data(P, frac_train, seed):
    rng = random.Random(seed)
    pairs = [(a, b) for a in range(P) for b in range(P)]
    rng.shuffle(pairs)
    cutoff = int(len(pairs) * frac_train)
    train, test = pairs[:cutoff], pairs[cutoff:]
    return train, test

def make_tensors(pairs, P, device):
    """pairs: [(a,b),...] → tokens (B,3) 形如 [a, b, P],labels (B,) 为 (a+b)%P"""
    tokens = torch.tensor(pairs, dtype=torch.long, device=device)   # (B, 2)
    eq = torch.full((len(pairs), 1), P, dtype=torch.long, device=device)   # (B, 1) 全是 "="
    tokens = torch.cat([tokens, eq], dim=1)                          # (B, 3)
    labels = tokens[:, 0] + tokens[:, 1]                             # 注意:列0+列1 = a+b
    labels = labels % P
    return tokens, labels

# ----------------------------------------------------------------------------
# ③ 模型:1 层 transformer,无 LayerNorm
# ----------------------------------------------------------------------------
class GrokkingModel(nn.Module):
    def __init__(self, P, d_model=128, n_heads=4, d_head=32, d_mlp=512):
        super().__init__()
        self.P, self.d_model = P, d_model
        self.embed = nn.Embedding(P + 1, d_model)     # token 0..P-1 数字,token P 是 "="
        self.pos_embed = nn.Embedding(3, d_model)     # 位置 0,1,2
        # attention(4 头并行,写开便于阅读)
        self.w_q = nn.Linear(d_model, n_heads * d_head, bias=False)
        self.w_k = nn.Linear(d_model, n_heads * d_head, bias=False)
        self.w_v = nn.Linear(d_model, n_heads * d_head, bias=False)
        self.w_o = nn.Linear(n_heads * d_head, d_model, bias=False)
        # MLP
        self.w_in = nn.Linear(d_model, d_mlp, bias=True)
        self.w_out = nn.Linear(d_mlp, d_model, bias=True)
        # 输出层:残差流 → P 个答案的 logits
        self.unembed = nn.Linear(d_model, P, bias=False)
        self.n_heads, self.d_head = n_heads, d_head

    def forward(self, x):
        # x: (B, 3)
        B = x.shape[0]
        s = self.embed(x) + self.pos_embed(torch.arange(3, device=x.device))  # (B, 3, d)
        # ---- attention ----
        q = self.w_q(s).view(B, 3, self.n_heads, self.d_head).transpose(1, 2)  # (B,nh,3,dh)
        k = self.w_k(s).view(B, 3, self.n_heads, self.d_head).transpose(1, 2)
        v = self.w_v(s).view(B, 3, self.n_heads, self.d_head).transpose(1, 2)
        attn = q @ k.transpose(-1, -2) / (self.d_head ** 0.5)                  # (B,nh,3,3)
        causal = torch.triu(torch.ones(3, 3, device=x.device, dtype=torch.bool), diagonal=1)
        attn = attn.masked_fill(causal, float("-inf")).softmax(dim=-1)
        out = (attn @ v).transpose(1, 2).reshape(B, 3, self.n_heads * self.d_head)
        s = s + self.w_o(out)                                     # 残差
        # ---- MLP ----
        s = s + self.w_out(F.relu(self.w_in(s)))                  # 残差
        # ---- 读出:只用 "="(位置 2)的残差流 ----
        logits = self.unembed(s[:, -1])                           # (B, P)
        return logits

# ----------------------------------------------------------------------------
# ④ 主流程
# ----------------------------------------------------------------------------
def main():
    args = parse_args()
    torch.manual_seed(args.seed)
    np.random.seed(args.seed)
    random.seed(args.seed)
    device = "cuda" if torch.cuda.is_available() else "cpu"
    print(f"设备 {device} | P={args.p} 训练占比={args.frac_train} d_model={args.d_model} "
          f"lr={args.lr} wd={args.wd} steps={args.steps} seed={args.seed}")

    train_pairs, test_pairs = make_data(args.p, args.frac_train, args.seed)
    print(f"数据: 共 {args.p*args.p} 对,训练 {len(train_pairs)} / 测试 {len(test_pairs)}")

    model = GrokkingModel(args.p, args.d_model, args.n_heads, args.d_head, args.d_mlp).to(device)
    print(f"模型: {sum(p.numel() for p in model.parameters()):,} 参数(无 LayerNorm)")

    opt = torch.optim.AdamW(model.parameters(), lr=args.lr,
                            betas=(0.9, 0.98), weight_decay=args.wd)

    watcher = None
    if args.watch:
        sys.path.insert(0, os.path.join(os.path.dirname(os.path.abspath(__file__)), "..", "param-watch"))
        from param_watch import ParamWatcher
        watcher = ParamWatcher(model, every=500)

    os.makedirs(args.outdir, exist_ok=True)
    csv_path = os.path.join(args.outdir, "curve.csv")
    log_path = os.path.join(args.outdir, "log.txt")
    csvf = open(csv_path, "w", newline="")
    cw = csv.writer(csvf)
    cw.writerow(["step", "train_acc", "test_acc", "train_loss", "test_loss"])
    logf = open(log_path, "w")

    # 全批量训练:每步把全部训练对过一遍(与 Nanda demo 一致)
    train_tokens, train_labels = make_tensors(train_pairs, args.p, device)
    test_tokens, test_labels = make_tensors(test_pairs, args.p, device)

    memorize_step, grok_step = None, None
    t0 = time.time()
    for step in range(1, args.steps + 1):
        logits = model(train_tokens)
        loss = F.cross_entropy(logits, train_labels)
        opt.zero_grad()
        loss.backward()
        opt.step()

        if step % args.eval_every == 0:
            ta, va = eval_acc(model, train_tokens, train_labels), eval_acc(model, test_tokens, test_labels)
            tl = loss.item()
            vl = eval_loss(model, test_tokens, test_labels)
            line = (f"step {step:6d} | train {ta:6.1f}% | test {va:6.1f}% | "
                    f"train_loss {tl:.4f} | test_loss {vl:.4f} | {time.time()-t0:5.1f}s")
            print(line)
            logf.write(line + "\n")
            cw.writerow([step, ta, va, tl, vl])
            csvf.flush()
            if memorize_step is None and ta >= 95.0:
                memorize_step = step
            if grok_step is None and va >= 95.0:
                grok_step = step
            if watcher:
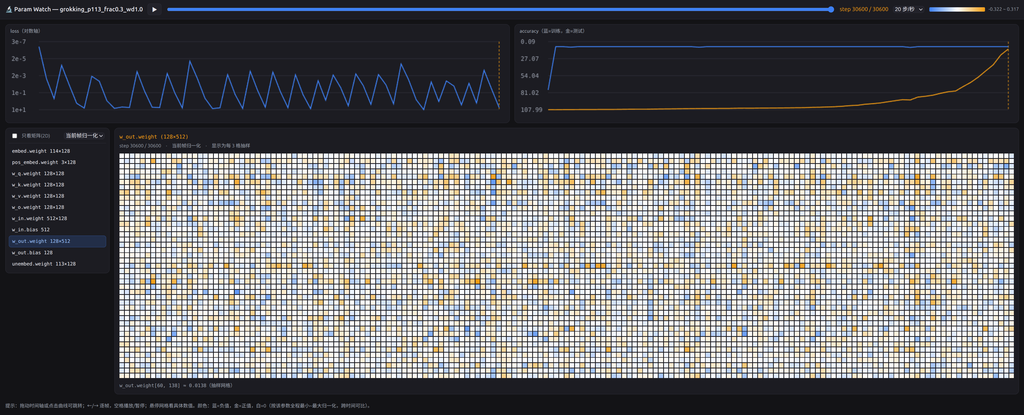
                watcher.snapshot(step, loss=tl, train_acc=ta, test_acc=va)

        if memorize_step is not None and grok_step is not None and step > grok_step + 500:
            break

    csvf.close(); logf.close()

    if watcher:
        view = watcher.save(os.path.join(args.outdir, "view.html"),
                            run_name=f"grokking_p{args.p}_frac{args.frac_train}_wd{args.wd}")
        print(f"参数热力图 → {view}")

    print("-" * 70)
    if grok_step is None:
        print("没有出现 grokking(测试集没到 95%)。试试调大 --steps 或改 --seed。")
    else:
        gap = grok_step - memorize_step
        print(f"记住训练集: step {memorize_step}")
        print(f"泛化到测试集: step {grok_step}")
        print(f"grokking gap(记忆→泛化的静默期): {gap} 步")
        print(f"曲线存于 {csv_path},日志 {log_path}")

def eval_acc(model, tokens, labels):
    model.eval()
    with torch.no_grad():
        pred = model(tokens).argmax(dim=-1)
        acc = (pred == labels).float().mean().item()
    model.train()
    return 100.0 * acc

def eval_loss(model, tokens, labels):
    model.eval()
    with torch.no_grad():
        return F.cross_entropy(model(tokens), labels).item()
    model.train()

if __name__ == "__main__":
    main()
Appendix A
集合 → 集合+运算+4公理 = 群 → 一圈能走完所有点 = 循环群 → 保运算的映射 = 同态 → 双射的同态 = 同构
的元素是p个等价类:
一个群: 集合+运算,满足四个条件:
- 封闭:
- 结合:
- 单位元:
- 逆元:
对于 和 mod 就是一个群
p = 5
G = range(p)  # {0,1,2,3,4}

def add(a, b): return (a + b) % p

# 封闭:所有结果都在 G 里
assert all(add(a, b) in G for a in G for b in G)
# 单位元 0
assert all(add(a, 0) == a for a in G)
# 每个元素有逆:a + (p-a) ≡ 0
assert all(add(a, (p - a) % p) == 0 for a in G)
# 结合律
assert all(add(add(a, b), c) == add(a, add(b, c))
           for a in G for b in G for c in G)
print("Z_5 对加法成群")循环群:整个群能被一个元素反复加自己生成。对于 只要和互质,就构成循环群
AI证明:
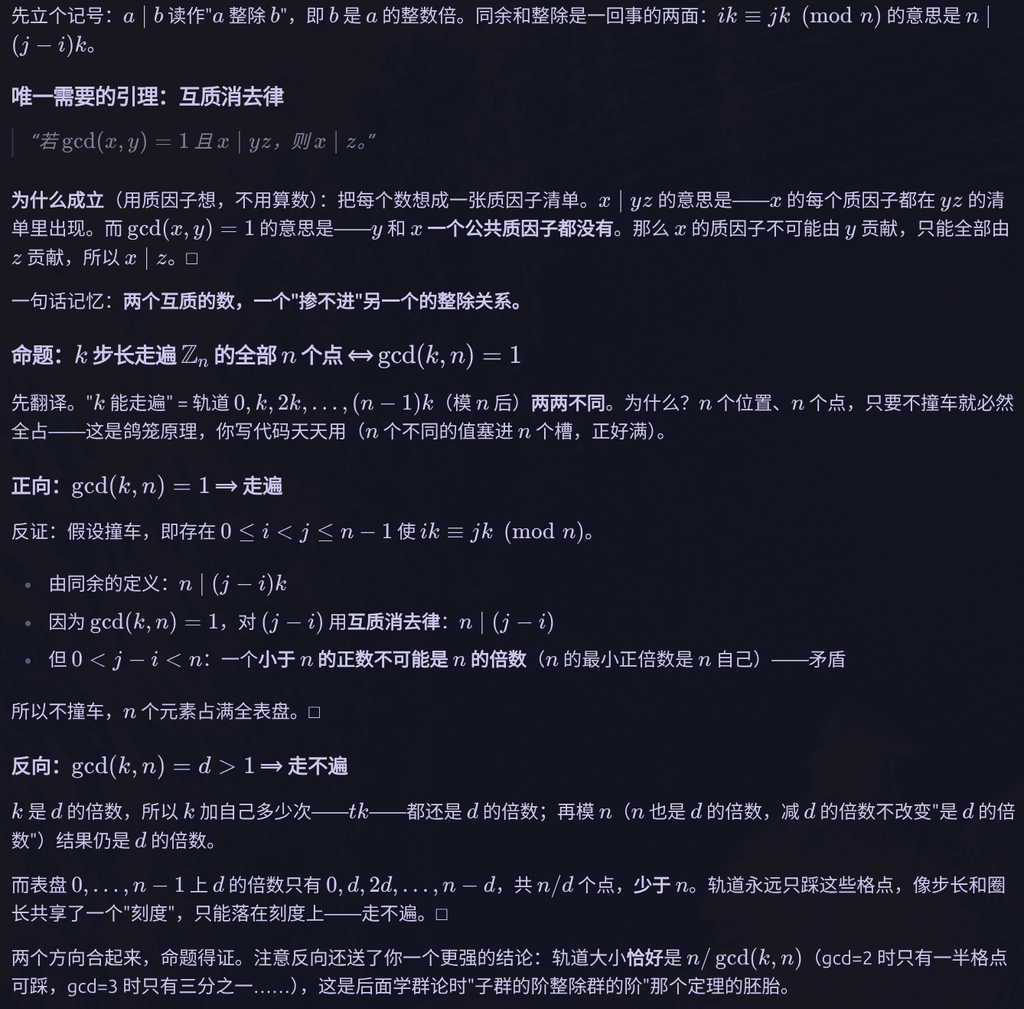
阶:一个元素要加自己多少次才回到0,1的阶是p,0 的阶是1。
同态:一种映射
f(x \cdot y) = f(x)\cdot f(y)
先计算后映射=先映射后计算
把的加法映射到单位圆的乘法
f(a)=e^{2\pi ia/p} \\ f(a+b)=f(a)f(b)此时 是一个同态,将加法取模的运算和在圆上旋转的运算联系了起来。所以网络在训练中学到的就是这个群同态,它学会了运算的频率基,即特征标。
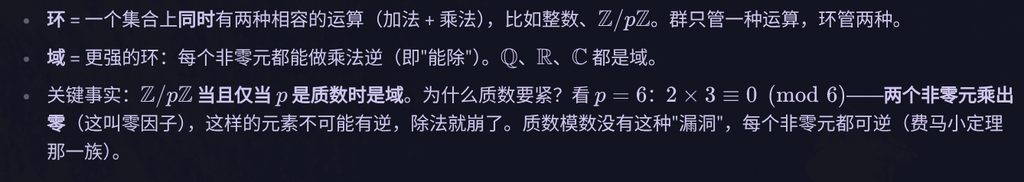
论文中提到加法模p-1和乘法模p不能被模型区分,其含义就是这两个群事实上是同构的。
两个群同构 = 存在一个双射同态(一一对应、可逆、两边都保运算)。
同态允许压扁(多对一,丢信息);同构是纯粹的换名,运算表结构一模一样。
类似函数的单射和双射。
我们之前证明了加法群 和元素是一个群,其中单位元为,的逆元为
乘法群 对于元素也是一个群, 其中单位元为1,的逆元为
对于乘法群,循环的方式也是乘法,所以x是等差数列,当,正好循环一圈此时元素回到1
由此可见加法群和乘法群事实上是同构的
Appendix B
从同态到特征标:grokking 的「规则解」长什么样
一个同态不够,一族才够
f(a) = e^{2πia/p} 是 ω=1 的情形。对每个整数频率 ω 定义:
\chi_\omega(a) = e^{2\pi i\,\omega a / p}验证它也是同态——只用了同底数幂相加的性质:
\chi_\omega(a+b) = e^{2\pi i\omega(a+b)/p} = e^{2\pi i\omega a/p}\cdot e^{2\pi i\omega b/p} = \chi_\omega(a)\cdot\chi_\omega(b)χ_ω 叫频率 ω 的特征标。 是常值 1(平凡特征标);与 互为共轭(对应 cos/sin 两个实方向)。p 个特征标构成 p 维函数空间的一组正交基——就是离散傅里叶基。
规则解 = 用特征标实现运算表
目标:实现 (a, b) ↦ a+b mod p。如果 token 被编码成相位,那「组合两个 token」就变成「组合两个相位」——而乘积结构天然产生相位和:
\chi_\omega(a)\cdot\chi_\omega(b) = \chi_\omega(a+b)
(实数写法就是 cos(α+β) = cosα·cosβ − sinα·sinβ。)任何「把两个向量相乘/点积」的结构——注意力正是这种结构——都能高效地做这个组合。这就是为什么 transformer 能学会加法规则,而且学得比「死记」更省。
定理(有限阿贝尔群傅里叶分解):任意函数 g: Z_p → ℂ 都能唯一写成
g(a) = \sum_{\omega=0}^{p-1} \hat{g}(\omega)\,\chi_\omega(a)特征标是这个函数空间的正交基——就像任意信号都能分解成频率分量。含义:网络能用的「规则解」,本质上就是在特征标基里选系数。
圆 = 单一频率的特征标
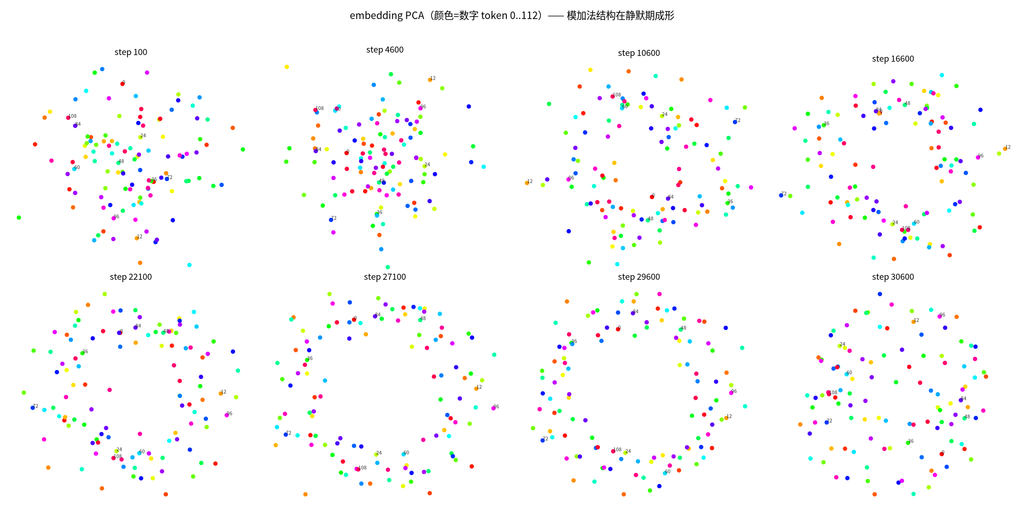
PCA 看到的环,现在有了精确的数学身份:token a 的 embedding 投影到 2 维平面后 ≈ scale·(cos 2πωa/p, sin 2πωa/p)——恰好是 χ_ω 的实部 + 虚部。
– PCA 找到的那个 2 维子空间 = 频率 ω 的 cos/sin 平面
– 环 = 这个特征标的几何形状(a 每 +1,相位转 2πω/p;绕 ω 圈闭合)
– 环拟合度 0.995 = embedding 几乎完全躺在这个平面上
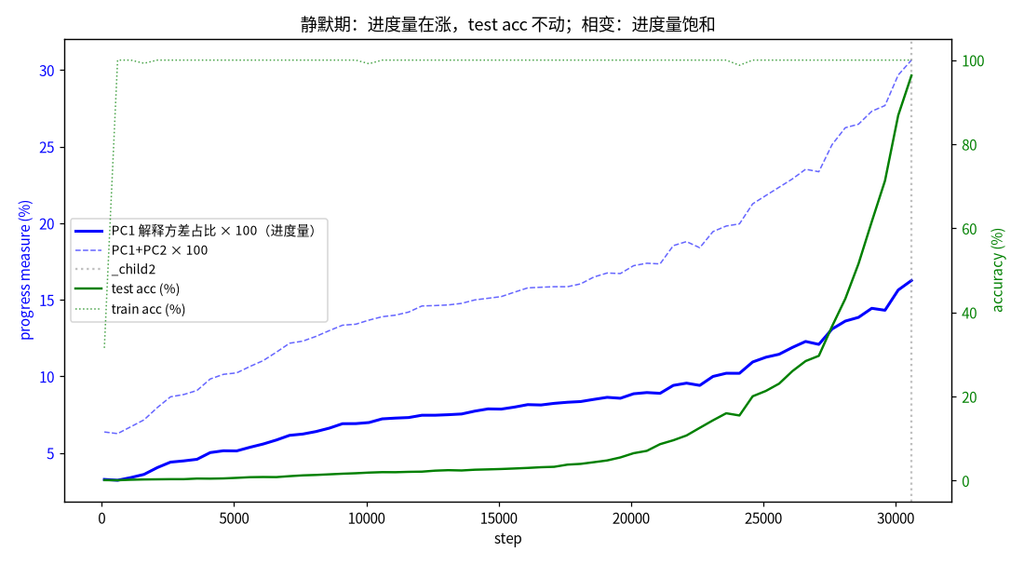
– 静默期的进度量(PC1% 从 3.3% 单调涨到 16%) = 这个频率分量从噪声里长出来的轨迹
论文图 3 右也是环——但那是输出层的行向量。两侧是对偶关系:embed 是编码器(符号 → 相位),unembed 是解码器(相位 → 符号),中间的电路做「相位算术」。
weight decay 为什么恰好选中它(Varma 2023 电路效率的雏形)
把解看成电路,算「范数账本」。两种解都能把训练 loss 压到 ~0,但成本不同:
– 记忆解:p² 个训练对,每对要独立「钉」一个输出 → 能量被迫摊在所有频率/模式上 → 范数大(embedding 各行必须互不干扰、logit 要高)
– 规则解:单一频率 χ_ω 只有 2 个实方向(cos、sin),embed 侧 2 个 + unembed 侧 2 个 ≈ 4 个自由度 → 范数极小(相位编码:幅度小不影响相位关系)
wd 每步按范数收税 → 系统在同 loss 的解里持续倾向范数最小的 → 规则解胜出。数学内核:特征标正交归一,用它实现任务时能量可精确集中(Parseval 定理);记忆解的能量被迫摊薄。
我们观察到的证据链:embedding 总范数 112 → ~2(税在收),同期环拟合度 0.2 → 0.995(规则解在长)。
环 ≠ 泛化:电路要对齐(Nanda 的门槛)
我们实测:环 ~10k 步就成形(拟合度 0.9+),但 test acc 到 ~30k 才突跳。中间两万步,电路其余部分(QK 权重、读出层)在对齐——单有 embedding 的环不够,整条链必须同时就位。
Nanda 2023 做的事:给每个电路部件定义可量化的「进度量」(embedding/读出层的傅里叶分量大小、QK 电路权重等),发现它们都单调增长,并且同步越过某个阈值时 test acc 突跳——相变是阈值效应,不是渐变。
grokking 的规则解 = 网络在符号空间里自己发现了特征标:embedding 把符号编码成相位(一个圆),电路做相位算术,读出层解码回符号。这个解范数最小,所以 weight decay 一路把它从记忆解底下「税」出来。静默期不是什么都没发生——是一条低范数电路在噪声里长齐的过程。